
一、一半規格的環境,測不出一半的效能
Day 16 你把及格線訂好了:下單 p95 < 800ms。興沖沖對測試環境跑了一輪,p95 是 1600ms。這時大腦會自動送上一個誘人的算式:測試環境規格只有正式的一半嘛,1600 除以 2,正式環境應該就是 800ms——剛好壓線,過關!
先別急著寫報告。這個算式假設系統是線性的,而 Day 1 那條曲線從第一天就告訴你:它是彎的。比例尺量不了彎的曲線。更麻煩的是,「規格一半」這句話本身就經不起追問——到底是什麼的一半?
• 有縮的:CPU 核心數、記憶體、節點數——這些通常真的是一半
• 根本沒縮的:網路延遲、資料庫連線池上限、逾時設定、程式邏輯——它們在兩個環境一模一樣
• 常常縮更兇的:DB 資料量——正式一千萬筆,測試環境一千筆,差的是四個數量級,不是一半
三種零件用三種比例在縮,組合出來的系統行為就沒有換算公式可言。正式環境 CPU 還很閒的時候,可能連線池先滿了;測試環境查詢飛快,可能只是因為資料少到整張表都在記憶體裡。瓶頸會轉移——你在半規格環境撞到的牆,和正式環境會撞到的牆,經常不是同一面。
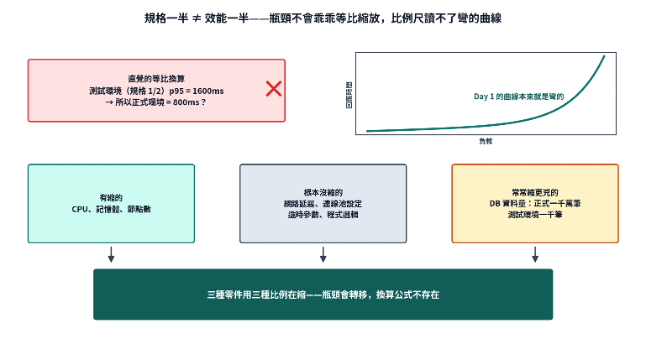
圖 1:規格一半 ≠ 效能一半——三種零件用三種比例在縮,瓶頸會轉移,換算公式不存在
二、三個隱形的數字扭曲器
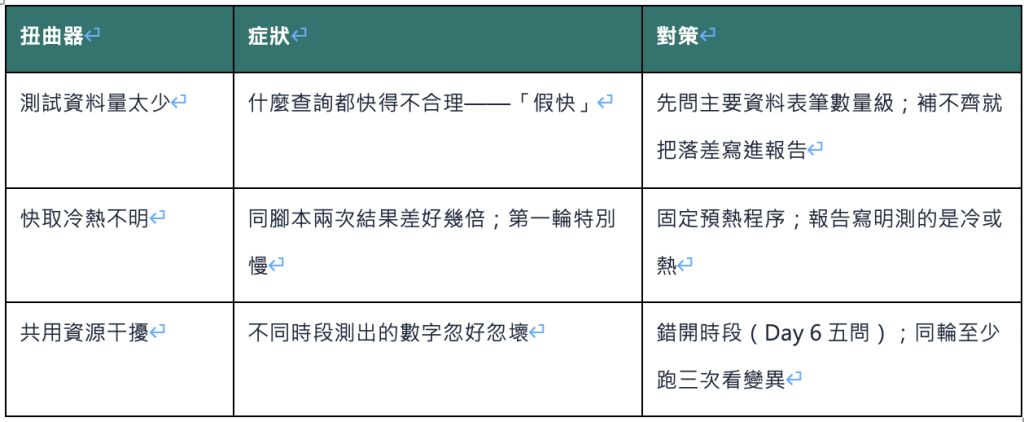
規格差異至少寫在採購單上,看得見。真正危險的是三個沒人告訴你的扭曲器——它們讓數字往「假快」或「假慢」的方向偏,而且偏得悄無聲息:
扭曲器一:測試資料量。一千筆和一千萬筆的查詢是兩回事。資料少的時候,再爛的查詢都快——沒有索引也快、全表掃描也快,因為整張表塞得進記憶體。等到正式環境一千萬筆,同一句 SQL 直接現形。測試環境的玩具資料,是「假快」最大的供應商。對策不難:開測前先問一句「這個環境的主要資料表有幾筆」,量級差太多就要求補資料,補不了至少把落差寫進報告。
扭曲器二:快取冷熱。系統剛啟動、快取是空的,第一波請求什麼都要真的算,慢;跑一陣子之後,熱門資料都在快取裡,快。同一個系統、同一個腳本,冷著測和熱著測可以差出好幾倍——那你的數字到底測到的是處理能力,還是快取命中率?對策是把「冷熱」變成有意識的選擇:固定一段預熱程序(先小流量跑一兩分鐘再開始計分),並在報告寫明這輪測的是預熱後的狀態;除非你要測的就是冷啟動情境(例如重啟後的恢復),那也寫明。
扭曲器三:共用資源。測試環境常常是好幾個團隊擠一台虛擬機、共用同一顆資料庫。你測到的 p95 裡,混著隔壁團隊跑批次的雜訊——今天測 900ms、明天測 1400ms,改的根本不是你的系統,是別人的排程。對策回到 Day 6 的老功課:問清楚誰在用、錯開時段;再加一條新習慣——同一輪測試至少跑三次,變異大到離譜,先懷疑環境不安靜,而不是急著懷疑系統。
三、四同一變:歪的尺也能量出差異
看到這裡你可能想問:環境規格不對、資料不夠、還有人跟我搶資源——那測出來的數字到底還有什麼用?答案是換一個問題問。「正式環境撐不撐得住」這一題,半規格環境確實答不好;但「新版比舊版快還是慢」這一題,它答得非常好。歪的尺量不出真實身高,可是同一把歪尺量兩次,長高了多少是真的。
這就是相對比較,操作紀律叫「四同一變」:同環境、同腳本、同資料、同時間窗——唯一變的,只有版本。改版前先量一輪 baseline 存下來,改版後用完全同一把尺再量一輪,比較的不是絕對值,是變化的方向與幅度:p95 從 1600ms 變 2300ms,+44%,新版變慢了——這個結論不需要環境和正式一樣就能成立。四同少了任何一同,比較就開始摻假:資料被昨天的壓測弄髒了(Day 9 的清理策略在這裡回收)、時段撞上別人的批次、腳本被順手改了一行 think time——變因一多,你就說不清楚差異是誰造成的。
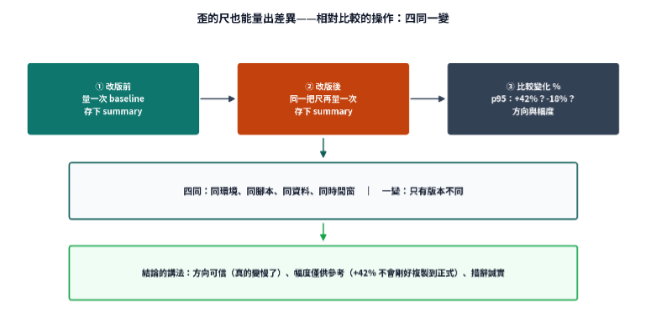
圖 2:相對比較的操作——四同一變;結論講方向、幅度僅供參考、措辭誠實
那 Day 16 訂的 SLO 怎麼辦?兩個務實做法:一是替測試環境訂一版自己的及格線——以這個環境的 baseline 為基準,「不比現況差、目標再快一成」,這正是 Day 16 第四條路的延伸;二是保留正式環境的 SLO 當長期目標,但報告裡的絕對值一律加註「於測試環境(規格為正式 1/2)測得,不代表正式環境表現」。兩個做法可以並用,共同點是措辭誠實——數字沒有錯,錯的是把它讀成它承擔不起的結論。
最後留一個界線:也不是所有結論都要退守到相對比較。錯誤(4xx/5xx、逾時)、功能性的崩潰、以及 soak 測試裡「越跑越慢」的趨勢——這些跨環境依然有意義:半規格環境會漏接一些問題,但它抓到的問題,正式環境幾乎都躲不掉。
四、動手做:親手製造一次「假快」,再做一次公平比較
練習一:冷與熱,親眼看差距。快取與連線重用的效果,用自己的數據看一次就終身難忘。對 QuickPizza 連續跑兩輪一模一樣的 smoke,比較兩輪的 p95:
Prompt 1|冷熱對照實驗
請連續執行兩輪完全相同的測試:k6 run --vus 2 --duration 30s pizza-api-test.js,
兩輪中間間隔 5 秒。記下兩輪的 http_req_duration(avg 與 p95),
做成對照表,並解釋第一輪通常較慢的原因
(連線建立、TLS 交握、伺服器端快取由冷轉熱),
以及這對「要不要預熱」的啟示。
公開練習站常年有流量,伺服器端早就是熱的,所以你看到的差距主要來自施壓端的連線建立與 TLS 交握——差距可能不大,但方向會很清楚。真實的內部測試環境剛重啟時,冷熱差距會比這誇張得多。
練習二:四同一變的完整演練。沒有真的改版可以測,我們就自己扮演那個「變」:拿 Day 13 的 journey 腳本當舊版,請 Claude Code 做一個會變慢的新版(多打一次 API,模擬改版加了新功能),然後走完整套相對比較:
Prompt 2|baseline 與新版對比
第一步:執行 k6 run --summary-export=baseline.json journey.js
第二步:把 journey.js 另存為 journey-v2.js,在下單流程裡
多加一次 GET 評分列表的請求(模擬新版多了推薦功能),其他都不變。
第三步:執行 k6 run --summary-export=v2.json journey-v2.js
第四步:讀取兩份 JSON,輸出對照表:
http_req_duration 的 avg/p95、iteration_duration、每次迭代的請求數,
各欄附上變化百分比,並用一句話總結新版變慢的原因。
指標                     baseline      v2         變化
http_req_duration p95    412ms         418ms      +1.5%
iteration_duration p95   6.21s         6.87s      +10.6%
每次迭代請求數           5             6          +1
結論: 單一請求沒變慢, 但流程多了一步, 整體旅程慢了一成
注意讀法:單一請求的 p95 幾乎沒動(伺服器沒變慢),但一輪旅程的耗時多了一成(流程變長了)——兩個指標說的是不同層的故事,混在一起就會誤判。這種「把兩份數據放在一起講出一個故事」的活,正是 Day 21 要讓 Claude Code 大展身手的地方,今天先淺嚐。
五、注意事項:讀數字最常見的六個坑
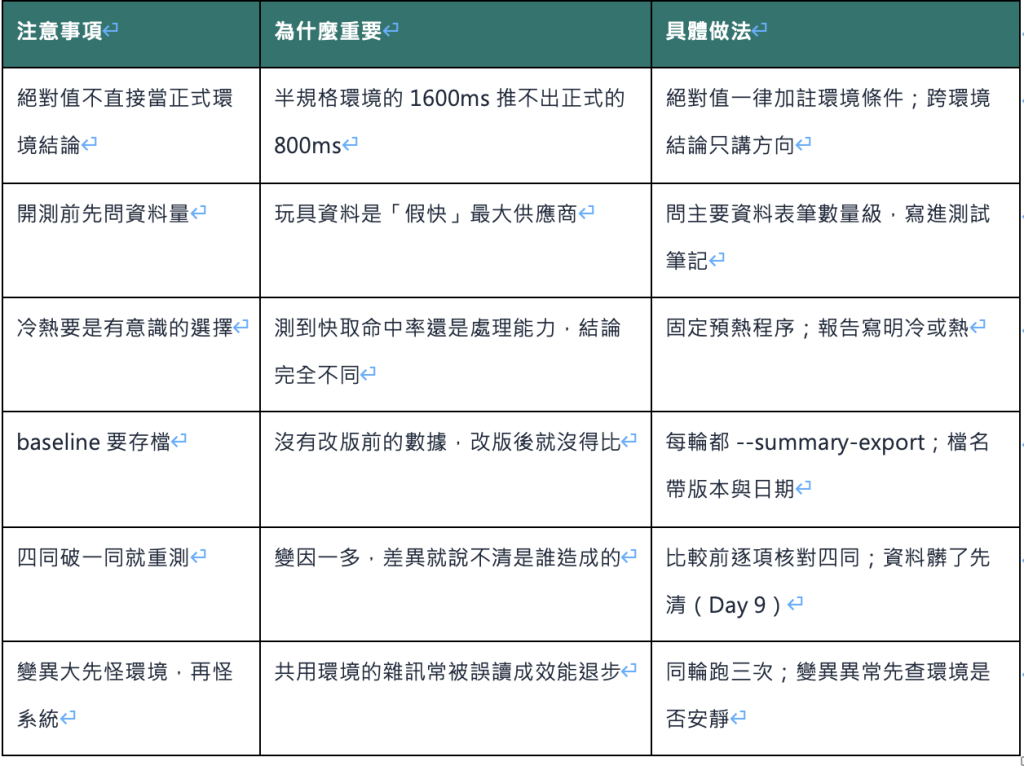
給 RD 的一句話:QA 來問「測試環境和正式差多少規格、DB 有幾筆資料」,這不是找碴,是他要把環境落差誠實寫進報告的前置作業。順手給他一張環境對照表吧——之後你收到的效能報告,就會從「這數字怪怪的」變成「這數字可以這樣讀」;而當他說「新版在同一環境慢了 40%」時,你可以直接開始找原因,不用先吵環境準不準。
六、觀念驗證:三個問題確認你有帶走今天的重點
• 測試環境規格是正式的一半,測出 p95 = 1600ms——為什麼不能推論正式環境是 800ms?至少講出兩個理由。(第一節)
• 三個扭曲器:資料量太少、快取太熱、隔壁在跑批次——各自把數字往「假快」還是「假慢」推?各說一個對策。(第二節)
• 主管問兩題:「新版比舊版快還是慢」「新版上了正式環境撐不撐得住」——哪一題你的半規格環境答得好?另一題該怎麼誠實回答?(第三節)
七、小結
環境落差不會因為抱怨而消失,今天學的是與它共處的方法:等比換算不存在,因為三種零件用三種比例在縮、瓶頸會轉移;資料量、快取、共用資源三個扭曲器,先認得、再對付;而當絕對值撐不起結論時,退守到「四同一變」的相對比較——方向可信、幅度僅供參考、措辭誠實。不過,相對比較只告訴你「變慢了」,還沒告訴你「慢在哪」。p95 多了四成,問題在應用層、資料庫還是網路?這就是判讀的下一層功夫——Day 18,我們來學怎麼從數字縮小範圍。
附錄:「這個數字能不能信」環境檢核清單(影印版)
—— 開測之前 ——
□ 1. 規格對照: CPU/記憶體/節點數與正式差幾倍? 記下來了嗎?
□ 2. 主要資料表的筆數與正式差幾個量級?
□ 3. 這輪要測冷還是熱? 預熱程序固定了嗎?
□ 4. 同時段有沒有別人在用這個環境? (Day 6 五問)
—— 比較之前 ——
□ 5. 四同核對: 同環境/同腳本/同資料/同時間窗?
□ 6. baseline 存檔了嗎? (--summary-export, 檔名帶版本日期)
□ 7. 同一輪至少跑了三次? 變異在合理範圍?
—— 下結論之前 ——
□ 8. 絕對值有沒有加註「於測試環境測得, 不代表正式環境」?
□ 9. 跨環境的結論是否只講方向, 不講絕對值?
□ 10. 錯誤與越跑越慢的趨勢, 有沒有另外列出? (這些跨環境仍有效)
```


 iThome鐵人賽
 看影片追技術